この研究のポイント
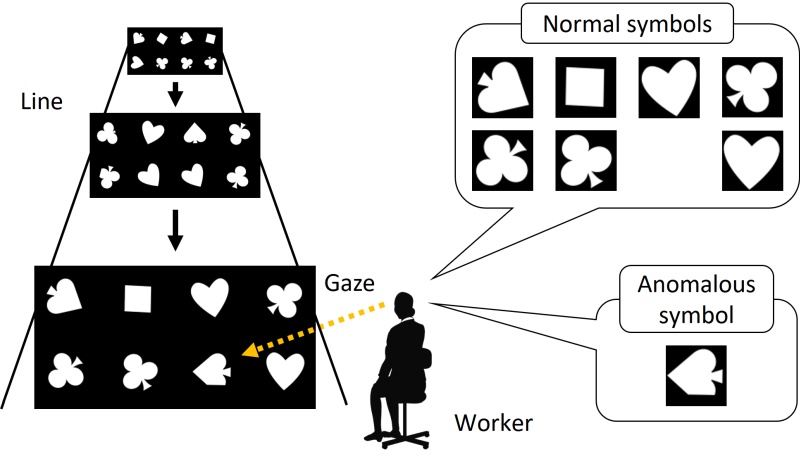
正常な記号と異常な記号を見分ける、専門知識を必要としない目視検査課題を用意します。人間と深層学習の精度や異常の見つけ方を比較し、必要な学習サンプル数を調べます。
概要
画像の中の異常を見つける作業で、コンピュータが人より正確に判断するには、どれくらいの練習用データが必要なのでしょうか。本研究では、専門知識がなくても取り組める、正常な記号と異常な記号を見分ける課題を用意し、人と深層学習を比較しました。
深層学習は、多くの例を通じて画像の特徴を学ぶ方法です。正常・異常の記号を含む画像を大量に自動生成し、学習に使う画像の数を変えながら精度を調べました。異常のある場所を見つける課題と、異常な記号が占める範囲を細かく切り分ける課題を扱い、異常の見つけ方にも注目しました。
実験の結果、異常の位置を検出するには数千個、記号の範囲を切り分けるには数万個の訓練サンプルが必要でした。また、深層学習には、人と比べて得意な点と不得意な点の両方がありました。これらは今回の単純な記号の検査で得られた結果で、必要なデータ数や得意・不得意を課題ごとに確かめることが大切だと分かります。
発表文献
- Naoto Kato, Michiko Inoue, Masashi Nishiyama, Yoshio Iwai,
Comparing the Recognition Accuracy of Humans and Deep Learning on a Simple Visual Inspection Task, Proceedings of 5th Asian Conference on Pattern Recognition (ACPR), 142, pp. 1 - 14, November 2019.
発表文献(日本語)
- 加藤 直人, 井上 路子, 西山 正志, 岩井 儀雄,
目視検査を模擬した単純タスクにおけるラベル欠損の検出精度の比較 ~深層学習が人間の目視と同等となるための訓練サンプル数の検証~,
精密工学会誌, vol. 86, no. 12, pp. 997 - 1005, December 2020.
