この研究のポイント
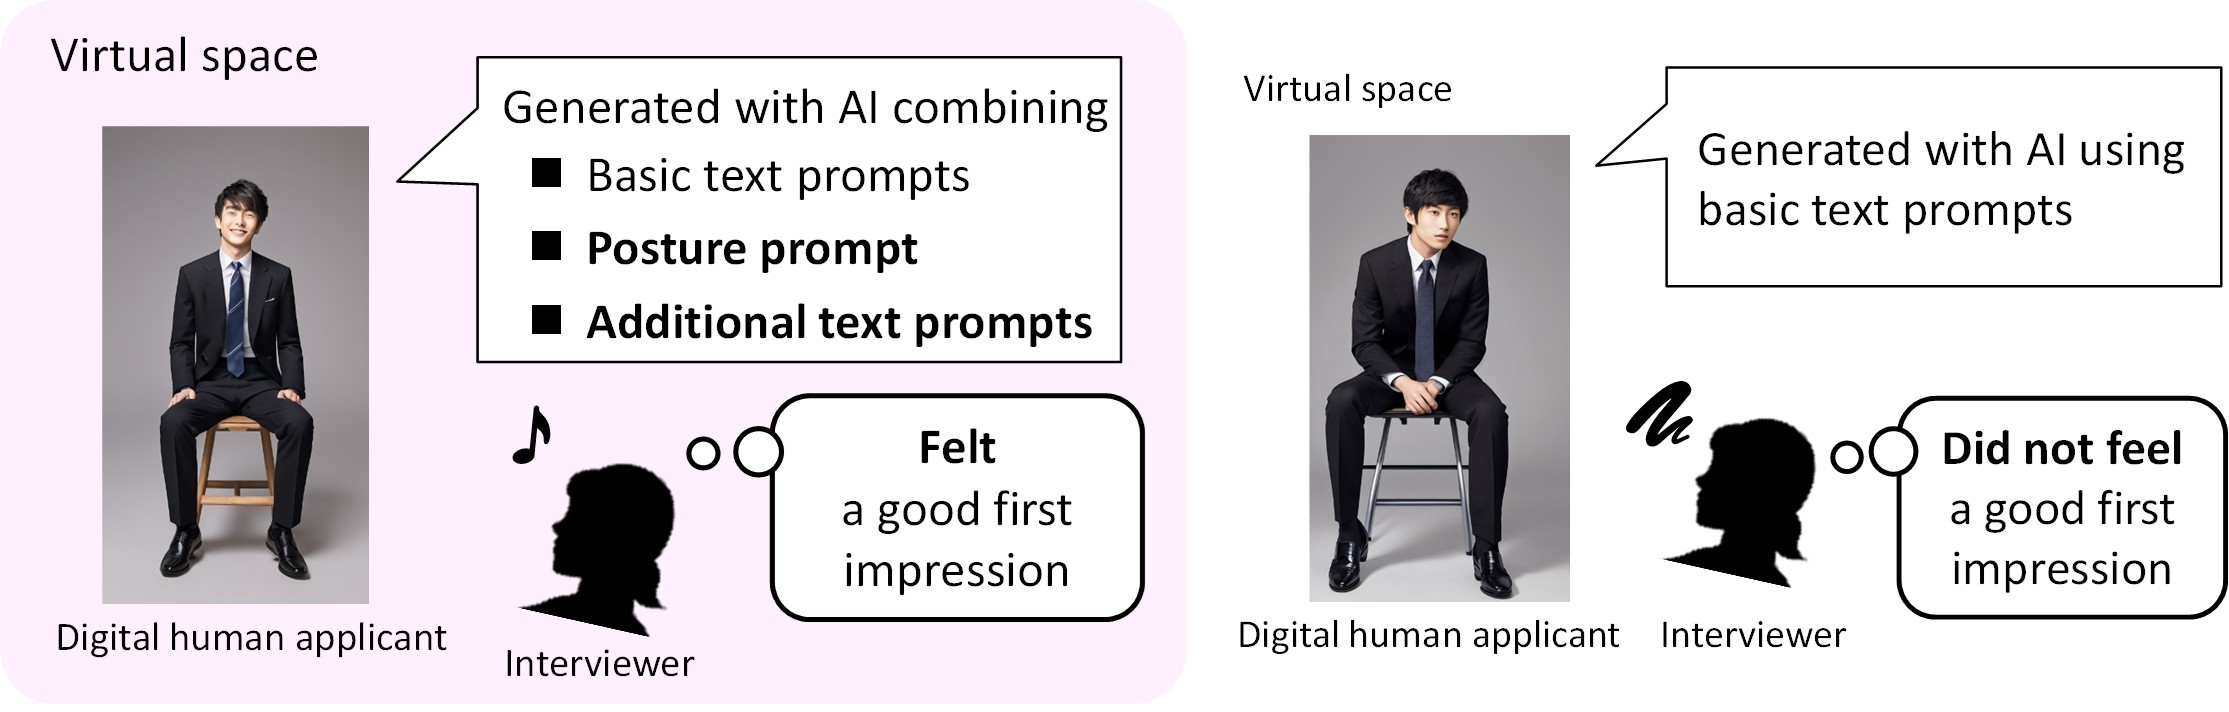
姿勢を指定するプロンプトとテキストの指示を組み合わせ、面接に参加するデジタルヒューマンの画像を生成します。面接官役の参加者による主観評価を通じて、生成条件と第一印象の関係を調べます。
概要
仮想空間で面接を受ける、コンピュータで作った人物を考えます。このような人物をデジタルヒューマンと呼びます。この研究では、その応募者の画像をAIで作るとき、姿勢についての指示と文章による追加の指示を組み合わせることで、面接官が受ける第一印象が変わるかを調べました。
AIに与える指示は「プロンプト」と呼ばれます。実験では、姿勢を指定するプロンプトを使うかどうか、文章による追加のプロンプトを使うかどうかを組み合わせて画像を作りました。参加者には仮想空間での面接官になったつもりで画像を見てもらい、第一印象を評価してもらいました。
その結果、姿勢と文章の指示を組み合わせた画像は、これらの指示を使わない条件の画像よりも、面接官役の参加者に良い第一印象を与えました。
関連文献
- Wataru Ganaha, Shota Hioki, Masashi Nishiyama,
First impression assessment of digital human applicant images generated with posture prompts and text prompts, Proceedings of 27th International Conference on Human-Computer Interaction (HCII), vol. DHM, pp. 185 - 199, June 2025. [Slides] - 我那覇 航, 日置 翔太, 西山 正志,
姿勢プロンプトとテキストプロンプトとの組み合わせにより画像生成された面接志願者の第一印象の主観評価,
HCGシンポジウム, A-1-3, pp. 1 - 8, December 2024. [Slides]
