この研究のポイント
複数の基準姿勢の画像をアンカーとして用意し、入力画像に適したアンカーを学習中に選択します。基準姿勢とのずれを小さくすることで、物体認識と姿勢推定を同時に改善します。
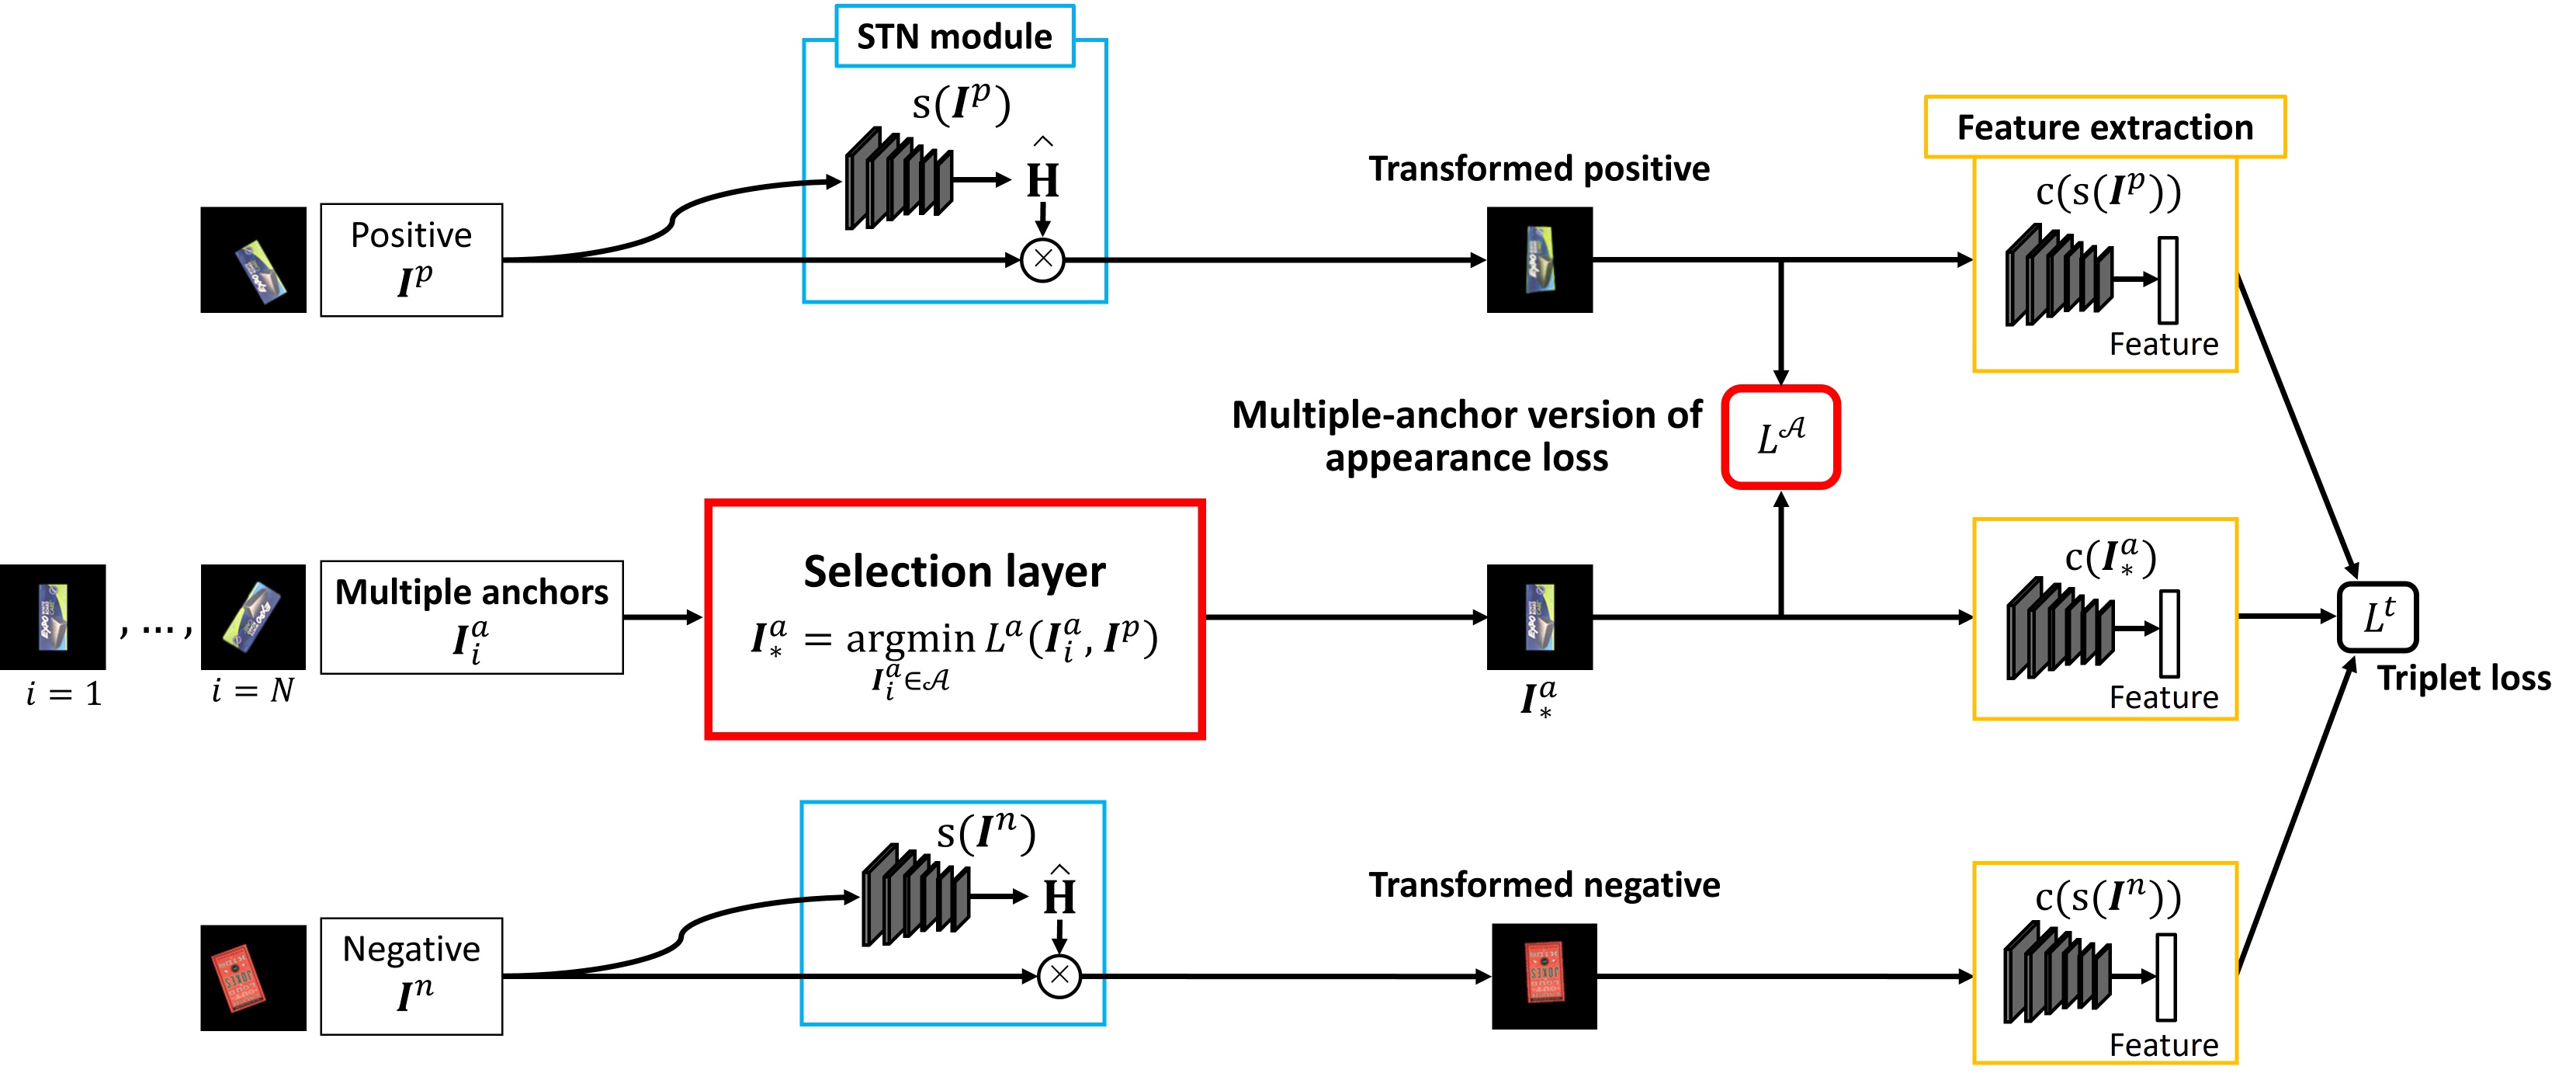
概要
ロボットが棚の商品をつかむには、「何の商品か」だけでなく、「どの向きを向いているか」も分かる必要があります。これを画像から学習させるには、通常、多くの画像に物体の種類や向きの正解を付けます。特に、向きを正確に調べて記録する作業には手間がかかります。
私たちは、物体を基準となる向きから撮った画像と見比べることで、向きの正解を一枚ずつ数値で付けずに、物体の種類と向きを同時に学習する方法を研究してきました。しかし、基準画像と向きが大きく違うと、推定が難しくなります。そこで本研究では、向きの異なる基準画像を複数用意し、入力画像に合うものを学習中に自動で選ぶ仕組みを加えました。
商品を取り出す場面を想定した3つの共通評価用データセットで検証したところ、比較した従来の方法よりも、物体の種類と向きの両方を正確に推定できました。基準画像を複数使うことが、見え方の大きな違いに対応するうえで有効だと分かりました。
関連文献
- Shunsuke Yoneda, Kouki Ueno, Go Irie, Masashi Nishiyama, Yoshio Iwai,
Joint Object Recognition and Pose Estimation using Multiple-anchor Triplet Learning of Canonical Plane,
Pattern Recognition Letters (PRL), Vol. 152, pp. 372 - 381, December 2021.
