研究の概念
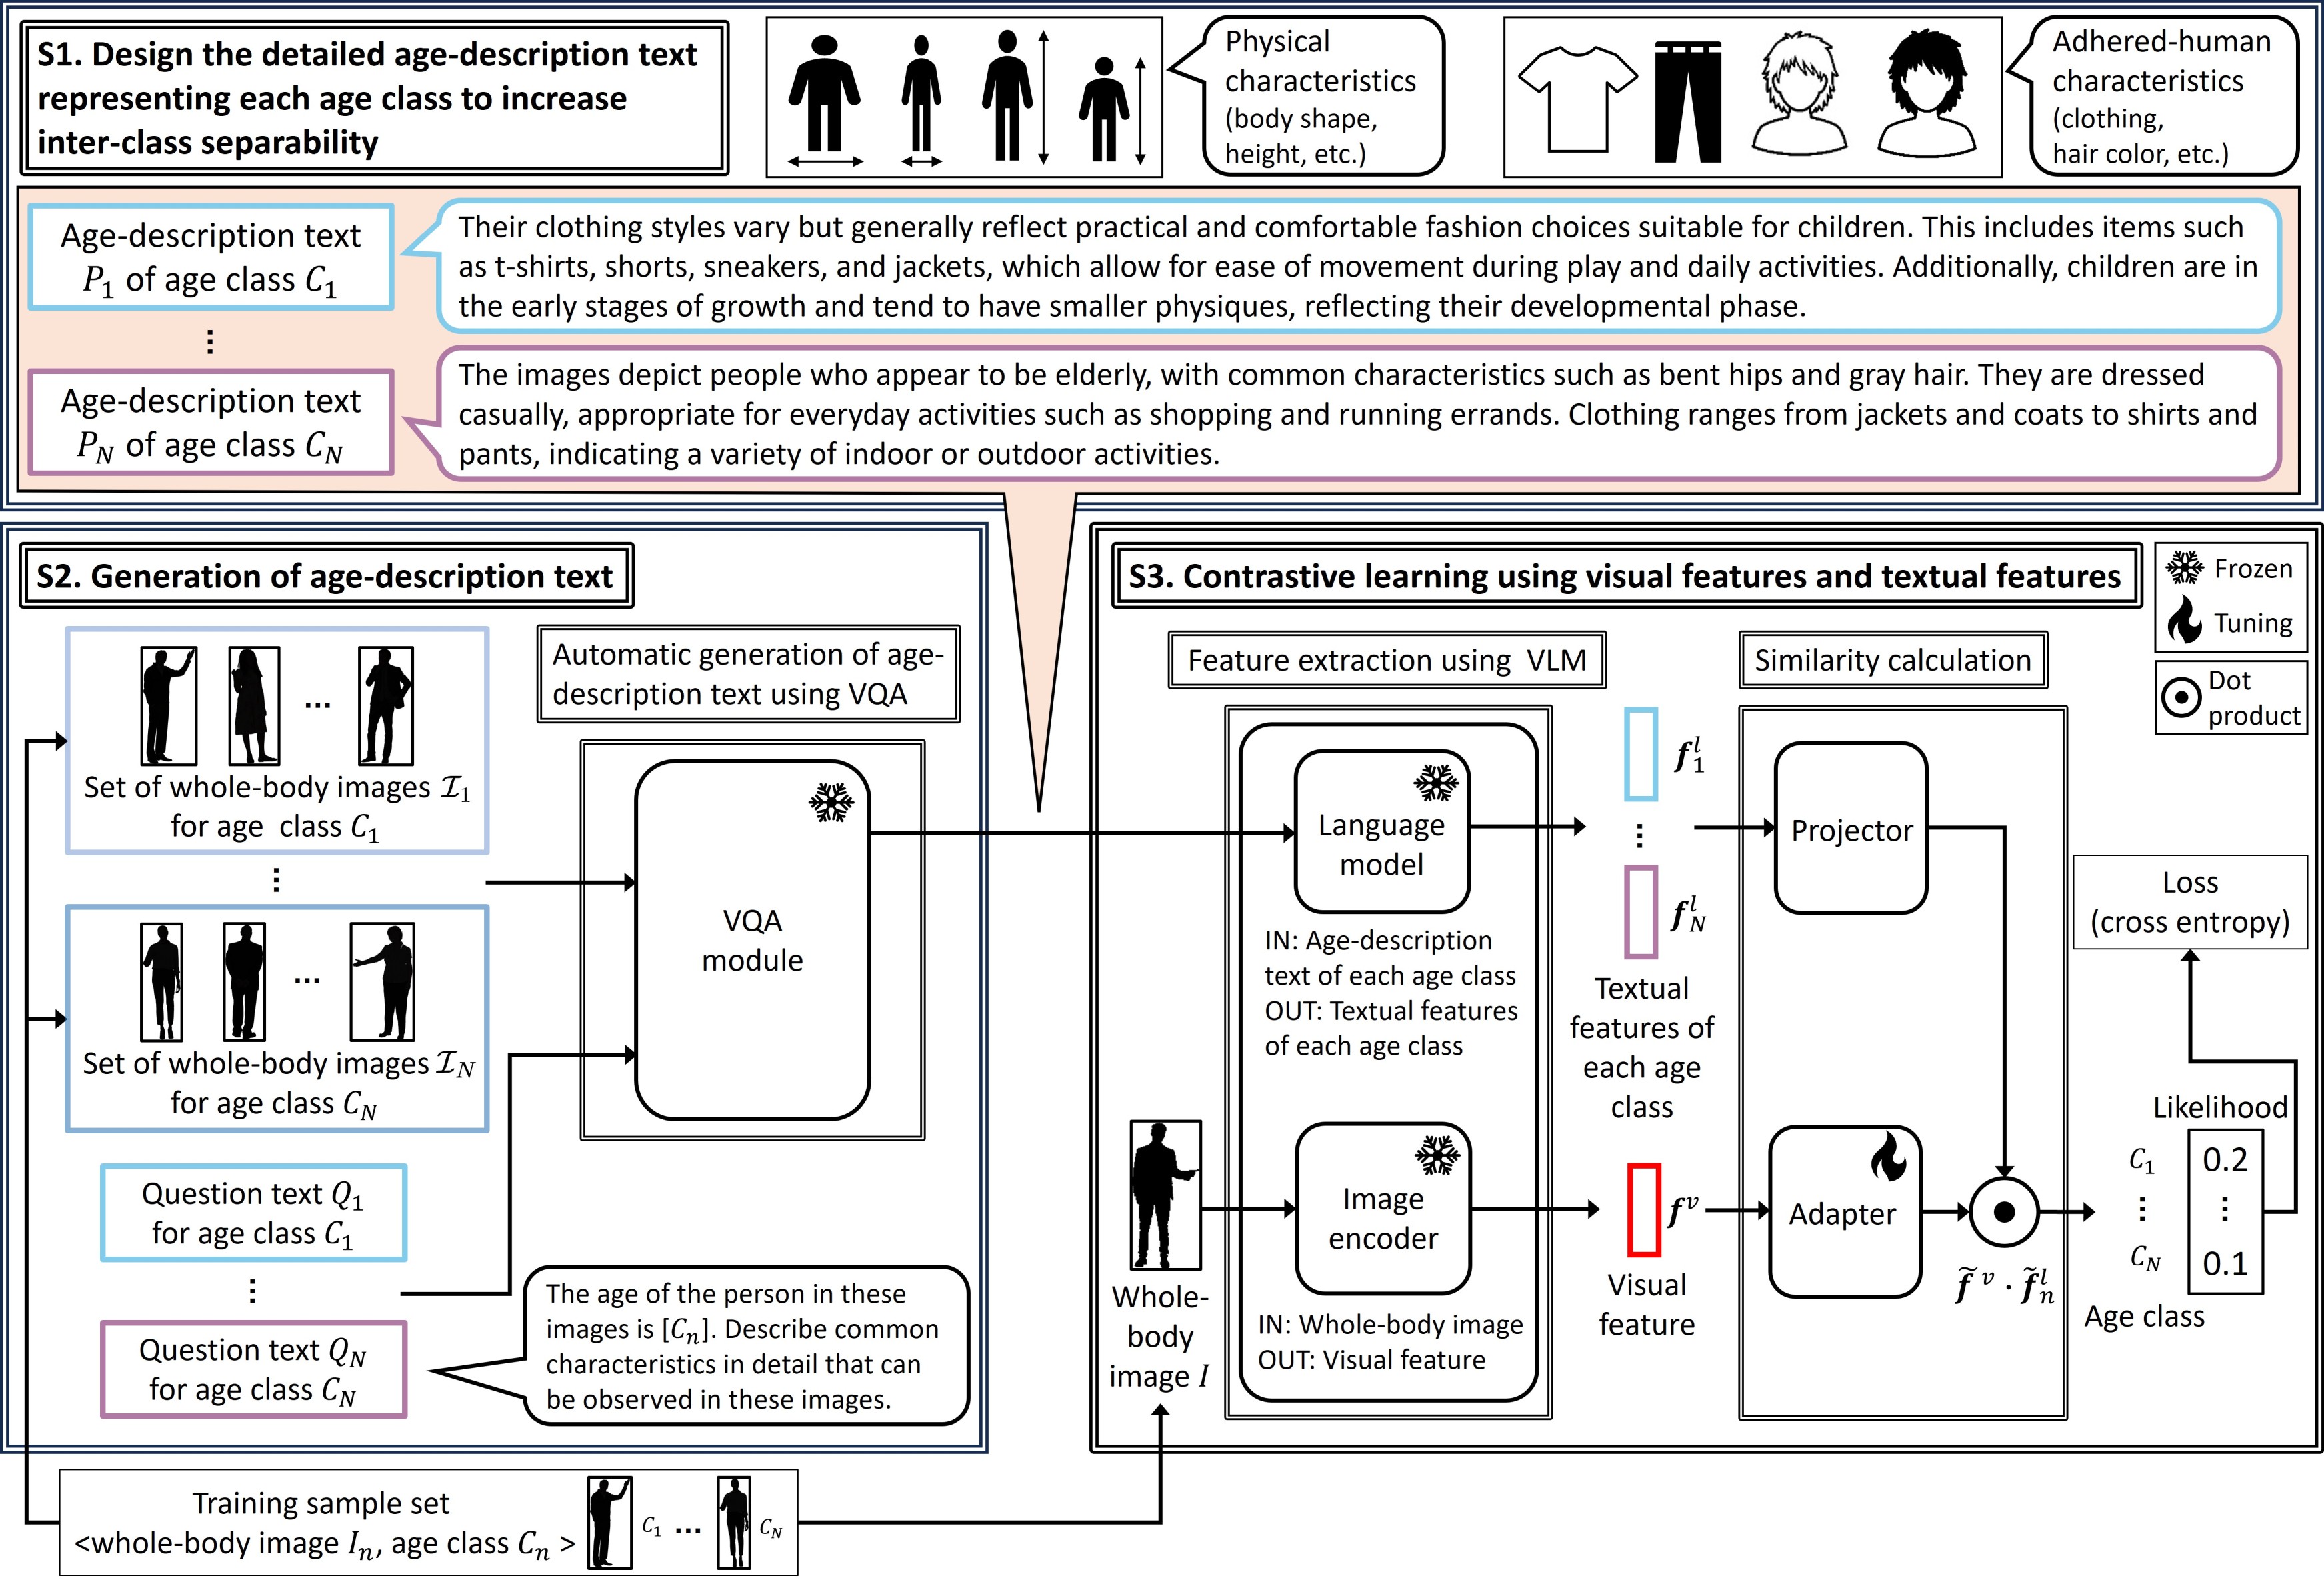
視覚言語モデルで年齢クラスごとの特徴を説明する文章を自動生成し、画像と文章の特徴を対照学習で対応付けます。人手による説明文の試行錯誤を抑えながら、歩行者の年齢認識を改善します。
概要
人手を最小限に抑えつつ、全身画像から歩行者の年齢クラスを正確に認識することが求められています。
近年の研究では、視覚言語モデル(VLM)の活用によって年齢認識の精度が向上しています。
しかし、VLMに与える年齢説明文は、年齢クラス間を十分に識別できるように設計されていません。また、説明文の準備には多くの手作業が必要です。
本研究では、年齢クラス間の分離性が高い、クラスごとの詳細な年齢説明文を自動生成し、対照学習の枠組みで利用することで、これらの課題に取り組みます。
提案手法は、各年齢クラスを表す身体的特徴や身に着けているものの特徴の語彙を拡張し、クラス間の分離性を高めます。
VLMを用いた視覚的質問応答(VQA)モジュールにより、簡潔な質問文から、試行錯誤を必要とせずに詳細な年齢説明文を生成します。
年齢説明文から識別性の高いテキスト特徴を得るとともに、対照学習によって、識別性の高い視覚特徴をテキスト特徴に対応付けます。
公開データセット(RAPv2.0、PETA、MSP60k、PA100k)を用いた実験では、平均年齢認識精度84.1%を達成し、最良のベースラインを4.6ポイント上回りました。
また、年齢説明文を手作業で作成する際の試行錯誤を解消できることを確認しました。
関連文献
- Takumi Ozaki, Hidenori Kuribayashi, Michiko Inoue, Masashi Nishiyama,
Pedestrian Age Recognition using Contrastive Learning by Automatically Generating Descriptions with High Inter-class Separability, IEEE Access, vol. 13, pp. 146492 - 146502, August 2025. [DOI] - 尾崎 匠, 西山 正志,
年齢認識および性別認識における手法・データセット・クラス不均衡に起因する精度変化の要因調査,
信学技報, vol. 125, no. 424, PRMU2025-60, pp. 102 - 107, March 2026. [Slides] - 尾崎 匠, 栗林 英範, 井上 路子, 西山 正志,
クラス間で良く分離された説明文を自動生成する大規模視覚言語モデルを用いた対照学習による歩行者年齢層認識,
信学技報, vol. 124, no. 445, PRMU2024-54, pp. 47 - 52, March 2025. [Slides] [Short movie]
